
Imagine descobrir que sua fatura mensal de API da OpenAI ou Anthropic é apenas a ponta do iceberg. Você projeta os custos com base no preço por token, mas ao final do trimestre, o valor gasto em infraestrutura, engenharia de prompts e mitigação de erros supera as projeções em até 580%. Isso não é falha de previsão; é uma consequência direta de como você escolhe a janela de contexto dos seus modelos de linguagem.
A maioria das empresas trata o tamanho da janela de contexto como um recurso técnico disponível, sem perceber que ele é alavanca principal para o Custo Total de Propriedade (TCO). Escolher a maior janela disponível não significa eficiência; muitas vezes, significa desperdício. Por outro lado, janelas muito pequenas forçam arquiteturas complexas que geram custos ocultos. Vamos entender como equilibrar essa equação para manter suas operações financeiramente saudáveis.
O Mito do "Quanto Maior, Melhor"
Existe uma ideia errada de que ter acesso a janelas de contexto de 1 milhão ou 2 milhões de tokens resolve todos os problemas de entrada de dados. A realidade econômica diz o contrário. O custo de processamento não escala linearmente com a quantidade de informação útil; ele escala com a quantidade total de tokens enviados para o modelo, mesmo que a maioria seja irrelevante.
Quando você envia um documento inteiro de 200.000 tokens para um modelo porque tem espaço sobrando, você paga pela atenção computacional dedicada a cada um desses tokens. Se a resposta precisa estar na página 3, você pagou pela leitura das outras 197 páginas. Essa ineficiência se acumula rapidamente em volumes altos. Estudos de campo em setores como serviços financeiros e telecomunicações mostram que organizações subestimam drasticamente seus custos reais quando ignoram esse fator. A escolha correta não é sobre capacidade máxima, mas sobre adequação precisa à sua carga de trabalho real.
Desvendando o Custo Total de Propriedade (TCO)
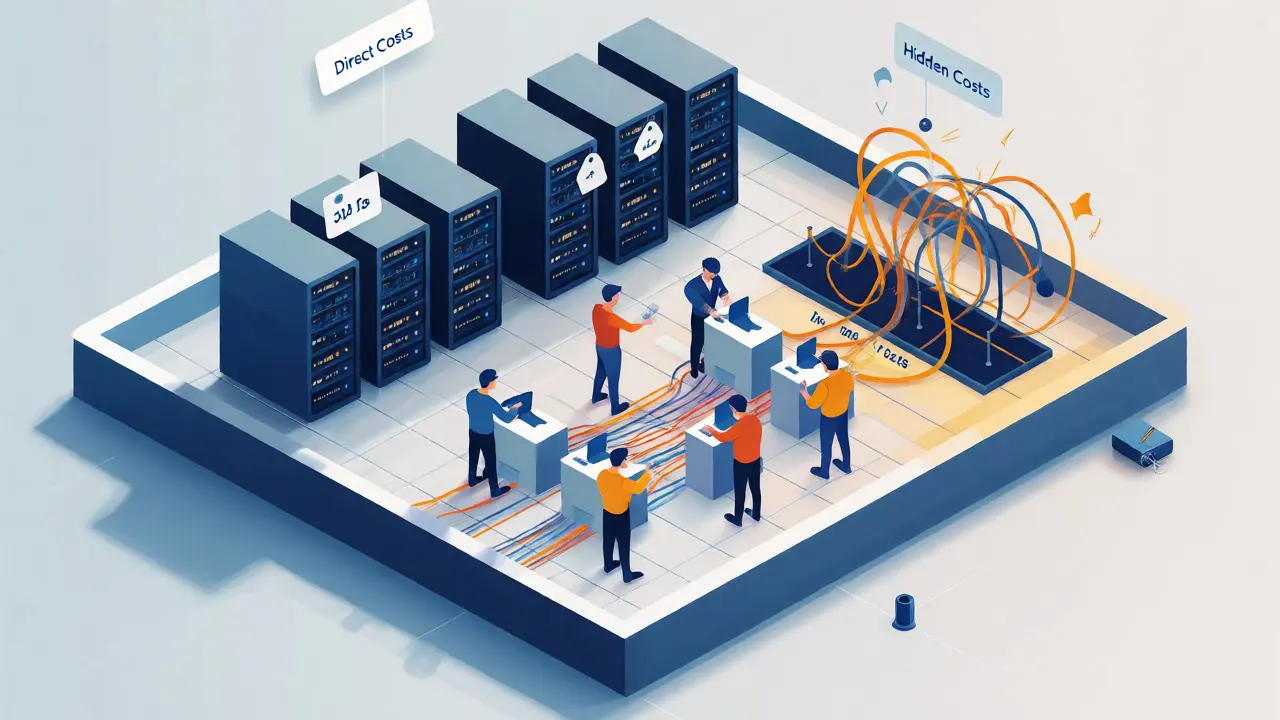
Para controlar os gastos, precisamos parar de olhar apenas para o preço por token. O TCO de uma implementação de LLM divide-se em três camadas distintas, e a janela de contexto afeta todas elas:
- Custos Diretos (35-45%): Inclui chamadas de API, consumo de tokens e infraestrutura de computação básica. Aqui, janelas maiores aumentam diretamente a conta mensal.
- Custos Indiretos (30-40%): Envolve mão de obra de engenharia para integração, manutenção de sistemas de recuperação de informação e monitoramento. Janelas menores exigem mais trabalho humano para ajustar prompts e pipelines.
- Custos Ocultos (20-30%): Inclui infraestrutura de retentativa (retry), mitigação de alucinações e otimização de latência. Arquiteturas complexas de fragmentação de documentos (chunking) criam pontos de falha que custam dinheiro para corrigir.
Uma análise de 47 implementações empresariais revelou que o uso exclusivo de calculadoras de preço de API cobre apenas 20-30% do custo real. A diferença está nos custos indiretos e ocultos, que são amplificados por decisões ruins de arquitetura de contexto.
Análise Comparativa de Modelos e Janelas
Em 2026, o mercado oferece opções variadas, mas cada uma vem com um trade-off específico entre tamanho de contexto e preço. Não existe um vencedor universal; depende do seu volume e complexidade.
| Modelo | Janela de Contexto | Custo Entrada (por 1M tokens) | Custo Saída (por 1M tokens) | Ideal Para |
|---|---|---|---|---|
| GPT-4o-mini | 128K tokens | $0.15 | $0.60 | Alto volume, tarefas simples |
| GPT-4o | 128K tokens | $2.50 | $10.00 | Raciocínio complexo, qualidade premium |
| Claude 3.5 Sonnet | 200K tokens | $3.00 | $15.00 | Documentos longos, precisão média |
| Gemini 1.5 Flash | 1M tokens | $0.075 | N/D (Foco em eficiência) | Processamento massivo de texto barato |
| Llama 4 Scout | 10M tokens | $0.11 | Variável (Self-hosted/API) | Contexto extremo, custo baixo por token |
Note a discrepância. O Gemini 1.5 Flash oferece uma janela de 1 milhão de tokens por centavos de dólar por milhão de tokens de entrada. Já o GPT-4o cobra $2.50 pela mesma unidade de medida, mas com uma janela de apenas 128K. Se o seu caso de uso não exige a qualidade superior de raciocínio do GPT-4o, pagar pelo contexto menor pode ser um erro estratégico. Por outro lado, o Claude 3.5 Haiku oferece 200K de contexto a um preço intermediário, sendo uma opção equilibrada para quem precisa de mais espaço que o GPT-4o-mini sem pagar o prêmio do Sonnet.
Estratégias de Roteamento Inteligente
A chave para reduzir o TCO não é escolher um único modelo, mas implementar um sistema de roteamento dinâmico. Analise a distribuição do comprimento das suas entradas. Na maioria dos casos, 95% das suas requisições cabem confortavelmente em janelas menores (como 32K ou 128K), enquanto apenas 5% exigem contextos gigantes.
Se você usar um modelo caro e lento para todas as requisições só para cobrir esses 5% extremos, estará subsidiando o custo excessivo para a maioria dos usuários. A solução? Orquestração inteligente.
- Triagem Prévia: Use um classificador leve ou regras simples para medir o tamanho do prompt antes de enviar ao LLM.
- Roteamento Hierárquico: Envie requisições curtas (<128K tokens) para modelos econômicos como GPT-4o-mini ou Gemini 1.5 Flash.
- Fallback para Complexidade: Reserve modelos com janelas maiores e preços mais altos (como Claude 3.5 Sonnet) apenas para os 5% de requisições que realmente precisam de todo aquele espaço.
Empresas que adotaram essa abordagem relataram reduções de custo entre 20% e 40%, mantendo a qualidade percebida pelo usuário final. O segredo está em não pagar por capacidade que não está sendo usada.
O Custo Oculto da Arquitetura de Recuperação (RAG)
Muitas equipes tentam economizar escolhendo modelos com janelas pequenas e implementando Retrieval-Augmented Generation (RAG) para injetar apenas os trechos relevantes de documentos longos. Parece lógico, mas esconde armadilhas financeiras significativas.
Um sistema RAG robusto não é gratuito. Ele exige:
- Infraestrutura Vetorial: Bancos de dados especializados para armazenar embeddings, que têm seus próprios custos de armazenamento e busca.
- Engenharia Contínua: Ajustar a granularidade dos chunks (fragmentos) e a lógica de recuperação é um processo iterativo que consome horas de desenvolvedores seniores.
- Latência Adicional: Cada etapa de recuperação adiciona tempo de resposta. Para aplicações sensíveis a latência, isso pode exigir hardware mais potente, aumentando a conta de nuvem.
Às vezes, é mais barato enviar o documento inteiro para um modelo com janela grande (como o Gemini 1.5 Pro) do que manter uma pipeline RAG complexa. Faça as contas: compare o custo adicional de tokens contra o custo de manutenção da infraestrutura de busca. Em muitos cenários de 2026, a simplicidade do "contexto longo nativo" vence a complexidade do RAG em termos de TCO.
Decisão Baseada em Volume Anual
Como decidir qual caminho seguir? Use seu gasto anual projetado com APIs como bússola:
- Menos de $50.000/ano: Foque em simplicidade. Use modelos pequenos e baratos como GPT-4o-mini. O overhead de criar arquiteturas complexas não se paga nesse nível.
- Entre $50.000 e $500.000/ano: Hora de misturar. Implemente roteamento híbrido. Use modelos hospedados para 80% do tráfego e considere modelos open-source auto-hospedados (como Llama 4 ou Gemma 3) para tarefas especializadas onde você pode controlar melhor os custos.
- Acima de $500.000/ano: Avalie a migração para infraestrutura própria. Com clusters de GPU bem utilizados e técnicas de fine-tuning (como LoRA), o custo por inferência cai drasticamente. Nesse ponto, o controle da janela de contexto permite otimizar a alocação de memória VRAM nas GPUs, reduzindo ainda mais o custo de energia e hardware.
Técnicas como quantização (reduzir a precisão dos números no modelo para 4-bits) podem cortar custos de GPU em até 30% sem perda visível de qualidade. Combinado com instâncias spot (preemptíveis) na nuvem, que oferecem descontos de 40-70%, a economia torna-se substancial para grandes volumes.
Perspectivas Futuras e Compliance
O cenário está mudando. À medida que os preços por token caem e as janelas de contexto padronizam em patamares como 128K, 200K e 1M, a competição vai se deslocar da capacidade bruta para a eficiência arquitetural. No entanto, para indústrias reguladas como saúde e finanças, surge um novo fator de custo: compliance.
Garantir trilhas de auditoria, residência de dados e comportamento determinístico pode forçar o uso de modelos comerciais mais caros ou investimentos pesados em segurança para infraestruturas próprias. Nesse contexto, escolher uma janela de contexto que minimize a necessidade de múltiplas chamadas de API (e, portanto, múltiplos logs de auditoria) pode simplificar a conformidade e reduzir custos operacionais indiretos.
Por que minha conta de API está tão alta se eu uso poucos tokens?
Provavelmente você está pagando por tokens de entrada irrelevantes devido a janelas de contexto superdimensionadas ou por custos indiretos como infraestrutura de RAG e retries de erro que não aparecem na fatura direta da API.
Vale a pena usar modelos com janelas de 1 milhão de tokens?
Sim, se seus documentos são naturalmente longos e você quer evitar a complexidade de fragmentação. No entanto, para documentos curtos, use modelos menores e mais baratos para não pagar por capacidade ociosa.
O que é TCO em LLMs?
Custo Total de Propriedade inclui não apenas o preço dos tokens, mas também custos diretos (infraestrutura), indiretos (engenharia, manutenção) e ocultos (latência, erros, compliance).
Como reduzir custos com janelas grandes?
Implemente roteamento inteligente: envie apenas requisições complexas para modelos caros com janelas grandes e use modelos econômicos para a maioria das interações simples.
RAG é sempre mais barato que contexto longo?
Não necessariamente. RAG exige manutenção constante, bancos de dados vetoriais e ajustes finos. Muitas vezes, o custo de manter o sistema RAG supera a economia de tokens obtida com janelas menores.
14 Comentários
Isso é óbvio para quem realmente entende de arquitetura de sistemas, não como a maioria dos 'engenheiros' que só copiam e colam código sem pensar na viabilidade econômica. O problema nunca foi o preço por token, mas a incapacidade das empresas brasileiras de dimensionar corretamente seus recursos antes de escalar. Nós já sabíamos disso há anos enquanto vocês ainda estavam descobrindo o que é uma API.
Interessante essa análise! 🤔 Nunca tinha parado pra pensar no custo oculto do chunking. Faz muito sentido mesmo 😅
Mano, sinceramente? Isso tudo é blá blá blá corporativo pra justificar aumento de fatura. Eu uso Gemini Flash direto e minha conta nem sente. Vocês complicam demais o simples. Se a resposta vem certa, qual o problema de mandar 1M tokens? É dinheiro que dá pra cortar em outro lugar, tipo aquele café caro da copa.
Ah, claro, porque ignorar os custos indiretos e tratar engenharia de prompt como algo trivial é sempre uma ótima estratégia financeira, né? 👏👏 A parte sobre 'mitigação de alucinações' ser um custo oculto é hilária considerando que metade das empresas nem sabe medir isso direito. Mas parabéns pela coragem de assumir que 95% das requisições são simples... deve ser lindo ver a realidade batendo na porta. 🙄💸
Que texto dramático e, ao mesmo tempo, tecnicamente preciso. A distinção entre custos diretos, indiretos e ocultos é crucial, embora eu discorde levemente da ênfase exclusiva no roteamento dinâmico sem mencionar a importância crítica da qualidade dos dados de entrada (garbage in, garbage out). A metáfora da 'ponta do iceberg' é clichê, mas adequada aqui. Lamento informar que muitas dessas 'implementações empresariais' citadas provavelmente falham justamente por negligenciar a limpeza prévia dos dados, gerando esses mesmos custos ocultos que você menciona. É uma tragédia recorrente na indústria. 💅📉
A busca pela eficiência máxima é, paradoxalmente, a maior inimiga da compreensão profunda. Ao fragmentar o contexto para economizar centavos, perdemos a nuance semântica que reside na totalidade. O TCO não é apenas financeiro; é epistemológico. Quando reduzimos a janela, estamos podando a capacidade cognitiva da máquina, e isso tem um preço existencial que as planilhas não capturam. Estamos trocando profundidade por velocidade, e será que vale a pena sacrificar a essência pelo lucro marginal?
Opa! Excelente ponto sobre o roteamento hierárquico! 🚀 Realmente, usar GPT-4o pra tarefa boba é desperdício puro. Vamos nessa que dá certo! 💪
EU JÁ FALEI ISSO MIL VEZES NOS MEUS WEBINARS!!! Ninguém me ouve, ninguém quer ouvir, todo mundo acha que pode jogar tudo pro modelo gigante e resolver! E quando a fatura chega, chora! Chora muito! É uma novela mexicana de tecnologia, gente! Todo mês é a mesma coisa, a mesma dor, o mesmo desespero no Slack! 😭😭😭
Fiquei pensando se essa lógica de roteamento se aplica bem a casos onde a latência é crítica. Se o classificador leve adicionar overhead, talvez o ganho de custo seja anulado pela experiência do usuário final. Alguém tem dados sobre esse trade-off?
É sério isso?? Tipo, a galera ainda paga 2.50 por milhão?? Eu tô usando modelos open source self-hosted e o custo é praticamente zero depois da infra inicial... Vocês tão jogando dinheiro fora, sério, tá doendo ver isso!! 😱💸💸
Curti a tabela comparativa. Ajuda bastante a visualizar as diferenças. O ponto sobre o Claude ser equilibrado é bem válido pra quem precisa de mais contexto que o mini mas não quer pagar o prêmio do Sonnet.
Gostei muito da abordagem holística apresentada no artigo, pois frequentemente vemos discussões isoladas sobre preço por token sem considerar o impacto sistêmico na cadeia de suprimentos de dados. A sugestão de triagem prévia é excelente, mas gostaria de complementar destacando a importância de manter logs detalhados de cada decisão de roteamento para auditoria futura. Além disso, a colaboração entre times de produto e engenharia é vital para definir essas regras de classificação, garantindo que não estejamos otimizando localmente às custas da satisfação global do cliente. É um esforço conjunto que traz resultados duradouros. 🌟
Que visão incrível! Adorei como você desmistificou o medo do custo. Com boas estratégias, dá pra ter performance sem quebrar o banco. Bora implementar isso! 🌈✨
Enquanto vocês debatem micro-otimizações de centavos, eu continuo vendo startups fecharem porque não têm receita. Custo de LLM é o menor dos problemas deles. Mas ok, segue o baile.