

Os modelos de linguagem grandes (LLMs) têm impressionado o mundo com a sua capacidade de gerar texto coerente, mas quando se trata de resolver problemas complexos que exigem planeamento passo a passo ou o uso preciso de ferramentas externas, eles frequentemente tropeçam. A culpa não é da inteligência bruta do modelo, mas sim da forma como ele "pensa". Tradicionalmente, os LLMs utilizam Cadeias de Pensamento (Chain-of-Thought), onde cada token gerado depende apenas do anterior, criando uma linha reta que pode acumular erros sem correção. É aqui que entram os Módulos de Raciocínio Estruturado (SCR - Structured Reasoning). Introduzidos formalmente em janeiro de 2026 através do artigo 'Structured Reasoning for Large Language Models' na arXiv, esta abordagem transforma o processo opaco de raciocínio num fluxo de trabalho transparente, dividindo a cognição artificial em componentes discretos: Gerar, Verificar e Revisar.
O Fim da Caixa Negra no Raciocínio Artificial
A grande inovação dos Módulos de Raciocínio Estruturado não está apenas em fazer o modelo pensar mais, mas em fazê-lo pensar melhor. Enquanto os métodos convencionais tratam o raciocínio como um bloco monolítico, o SCR desacopla as trajetórias de raciocínio em partes avaliáveis e treináveis. Pense nisso como a diferença entre um estudante que escreve a resposta final direto no exame e outro que mostra o seu trabalho, verifica cada cálculo e corrige os erros antes de entregar. Segundo Zhang et al. (2026), esta estrutura permite isolar capacidades específicas, tornando possível otimizar a geração inicial, a verificação crítica e a revisão condicional separadamente.
Os resultados são concretos. Em benchmarks de matemática de nível olímpico, o SCR-Stage I demonstrou ganhos de precisão de 12,7% comparado aos modelos base. Na competição AIME24, houve uma melhoria de 8,3%. O que torna isto fascinante para engenheiros de IA é a redução de passos redundantes. O SCR reduz o número de tokens gerados desnecessários em quase 40%, tornando o processo não só mais preciso, mas também mais eficiente computacionalmente em tarefas difíceis.
A Arquitetura GVR: Gerar, Verificar e Revisar
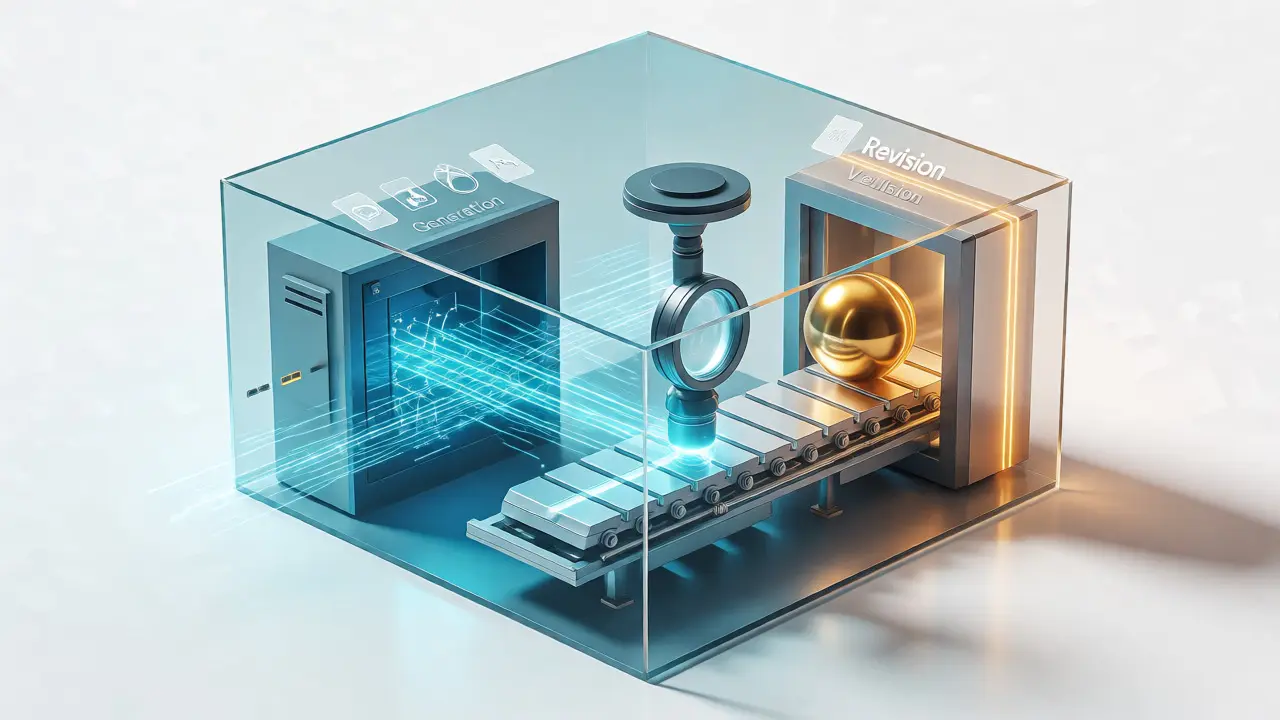
A implementação técnica segue um paradigma rigoroso chamado Generate-Verify-Revise (GVR). Não se trata apenas de prompt engineering; é uma alteração arquitetural no pipeline de treino e inferência.
- Fase de Geração: O modelo produz uma solução inicial utilizando geração autoregressiva padrão. É o ponto de partida bruto.
- Fase de Verificação: Aqui reside a magia. O modelo aplica mecanismos de autocrítica explícitos para avaliar a correção da solução. Estudos indicam que esta fase atinge 94,3% de precisão na identificação de erros lógicos.
- Fase de Revisão: Se a verificação falhar, o modelo revisa a solução condicionalmente. Este ciclo continua até que um limiar de confiança seja atingido ou o limite de iterações seja alcançado.
Um componente crítico nesta arquitetura é a Supervisão de Terminação Dinâmica (DTS). A DTS atua como um árbitro, decidindo quando parar de revisar com base na confiança da verificação. Isto resolve um problema persistente nos métodos tradicionais: o raciocínio descontrolado, onde o modelo continua a gerar texto irrelevante porque não sabe quando parar.
Treino por Reforço e Dados Estruturados
Treinar um módulo de raciocínio estruturado exige mais do que simples dados de texto. Os autores propõem duas metodologias principais. A primeira é o Fine-Tuning Supervisionado (SFT), que utiliza dois tipos de trajetórias: Trajetórias de Resposta Correta (onde a solução inicial já estava certa) e Trajetórias de Correção (onde a resposta inicial foi criticada e depois corrigida iterativamente).
A segunda metodologia é o Aprendizado por Reforço (RL) em duas etapas, utilizando Group Relative Policy Optimization (GRPO). A Etapa I foca-se em otimizar a capacidade de gerar e verificar, reduzindo alucinações em 32,1% em benchmarks difíceis. A Etapa II refina a capacidade de revisão, fornecendo sinais de aprendizado granulares para corrigir tipos específicos de erros. Esta abordagem em estágios garante que o modelo aprenda a reconhecer os seus próprios limites antes de tentar melhorar as suas soluções.
| Métrica | Chain-of-Thought (CoT) | Self-Consistency | SCR (Structured Reasoning) |
|---|---|---|---|
| Precisão em Matemática Olímpica | 58,7% | N/A | 71,4% |
| Precisão na Fase de Verificação | Baixa (implícita) | Média | 94,3% |
| Redução de Passos Redundantes | 0% (baseline) | ~15% | 39,5% |
| Custo de Inferência (Overhead) | Baixo | Alto (múltiplas amostras) | Moderado (+18-22%) |
Planeamento e Uso de Ferramentas Externas
Embora o SCR tenha começado com foco em raciocínio lógico interno, a sua integração com o uso de ferramentas (tool use) representa a próxima fronteira. Em novembro de 2026, observamos uma tendência clara: os módulos de raciocínio estruturado estão a ser adaptados para invocar calculadoras, APIs e bancos de dados durante a fase de revisão. Imagine um modelo a planear uma viagem: ele gera um itinerário, verifica a disponibilidade de voos via API (ferramenta externa) e revisa o plano se algum voo estiver indisponível.
Experimentos preliminares mostram que integrar ferramentas externas na fase de revisão melhora o desempenho em problemas de física em 18,7%. Isto acontece porque o modelo deixa de tentar "lembrar" constantes físicas ou fazer cálculos complexos mentalmente (o que é propenso a erros) e passa a delegar essas tarefas a ferramentas especializadas, focando o seu poder de processamento na lógica de planeamento.
Desafios de Implementação e Custos Computacionais
Nada vem de graça. Adotar o SCR aumenta o tempo de inferência em aproximadamente 18-22% devido às fases adicionais de verificação e revisão. Para aplicações sensíveis à latência, isto pode ser um obstáculo. Além disso, a construção de dados de treino de alta qualidade é trabalhosa. Criar Trajetórias de Correção requer supervisão humana significativa. Um usuário do Reddit relatou ter gasto 120 horas-pessoa para criar apenas 500 exemplos de treino de alta qualidade.
Outro desafio é a calibração dos limiares de confiança. Sem uma configuração cuidadosa, o modelo pode cair num loop infinito de revisão ou parar cedo demais. A maioria das equipas de engenharia relata necessidade de 3 a 5 iterações de ajuste fino para estabelecer critérios de terminação ótimos.
O Futuro da IA Estruturada
Analisistas da Gartner preveem que até ao quarto trimestre de 2026, 45% das implementações empresariais de LLMs que exigem raciocínio complexo incorporarão módulos de raciocínio estruturado. Grandes players como Anthropic e Meta já estão a incorporar princípios do SCR nas suas próximas versões (Claude 3.5 e Llama-4, respetivamente).
A questão central agora é a generalização. O SCR brilha em domínios com critérios de correção claros, como matemática e lógica. O próximo grande teste será a sua aplicação em domínios ambíguos, como escrita criativa ou diálogo aberto, onde a "correção" é subjetiva. Autores do paper original reconhecem esta limitação e planeiam introduzir verificação consciente de incerteza numa futura Etapa III.
O que são exatamente os Módulos de Raciocínio Estruturado?
São componentes arquiteturais em LLMs que dividem o processo de raciocínio em etapas discretas e avaliáveis: Geração, Verificação e Revisão. Ao contrário das Cadeias de Pensamento lineares, o SCR permite que o modelo critique e corrija o seu próprio trabalho de forma iterativa antes de fornecer a resposta final.
Qual a diferença principal entre SCR e Chain-of-Thought (CoT)?
O CoT gera uma sequência linear de pensamentos onde erros iniciais podem propagar-se sem correção. O SCR introduz um ciclo fechado de feedback, onde uma fase de verificação explícita avalia a solução intermédia e uma fase de revisão corrige erros específicos, resultando em maior precisão em tarefas complexas.
Como o SCR melhora o uso de ferramentas externas?
Durante a fase de revisão, o SCR pode identificar a necessidade de informação externa ou cálculo preciso e invocar ferramentas (como APIs ou calculadoras). Após obter o resultado da ferramenta, o modelo integra essa informação e revisa a solução, reduzindo alucinações causadas por cálculos internos imprecisos.
Quais são os custos computacionais do SCR?
O SCR aumenta o tempo de inferência em cerca de 18-22% comparado a modelos padrão, devido às fases adicionais de verificação e revisão. Também exige mais recursos computacionais durante o treino, especialmente na etapa de Aprendizado por Reforço (RL).
O SCR é útil para tarefas simples?
Não significativamente. Em tarefas simples como problemas de matemática escolar, onde o CoT já atinge quase 98% de precisão, o SCR oferece menos de 1,5% de melhoria. O seu valor real está em problemas complexos de lógica, planeamento e matemática avançada.