Compressão de LLMs vs. Troca de Modelos: Guia Prático para Decidir
Descubra quando comprimir Large Language Models e quando trocar por modelos menores. Analise custos, performance e riscos técnicos para otimizar sua infraestrutura de IA.
Ler mais
Descubra quando comprimir Large Language Models e quando trocar por modelos menores. Analise custos, performance e riscos técnicos para otimizar sua infraestrutura de IA.
Ler mais
Descubra como as novas Leis de Compressão alteram o escalonamento de LLMs. Entenda quantização, poda e os trade-offs reais entre velocidade e precisão em modelos de IA.
Ler mais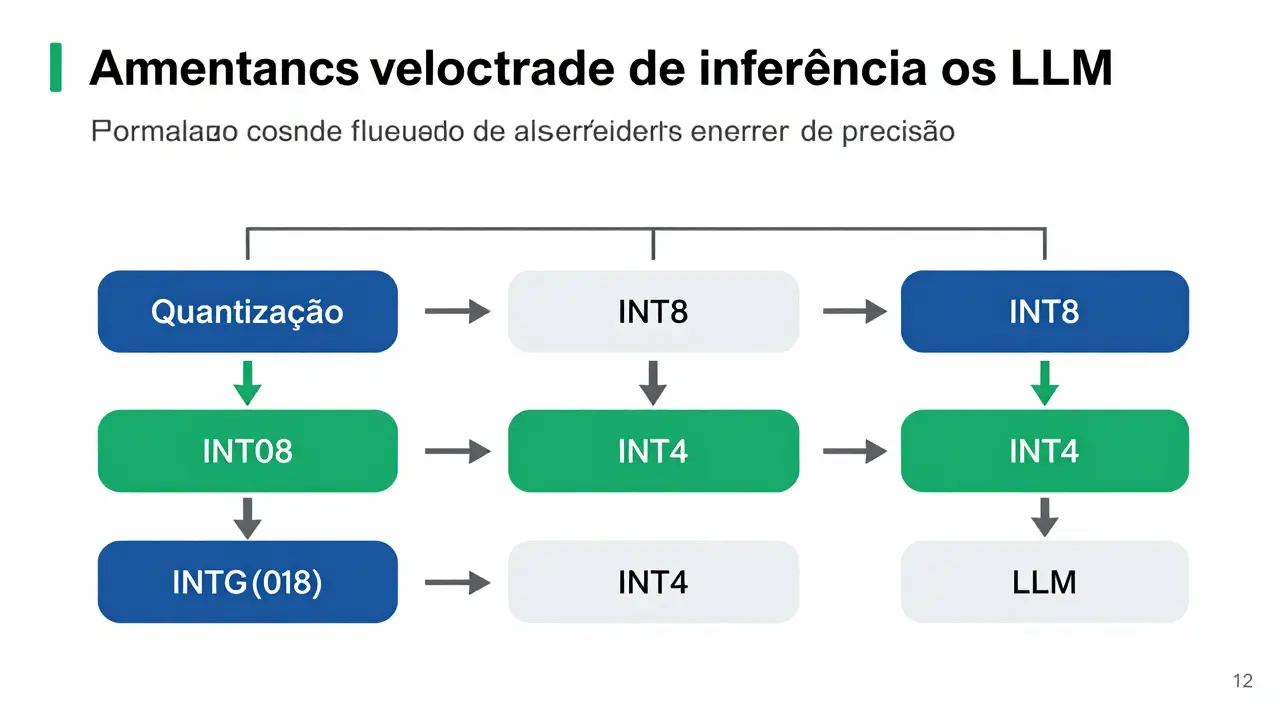
Descubra como reduzir custos de inferência de LLMs open-source em até 90% usando quantização, vLLM e cascateamento de modelos. Guia prático para 2026.
Ler mais