Você já parou para pensar como um modelo de linguagem consegue entender que a palavra "banco" se refere a uma instituição financeira em uma frase e a um assento em outra? A resposta não está em regras gramaticais rígidas, mas sim em três matrizes matemáticas que aprendem a "olhar" para o contexto. Estamos falando das projeções de Key (Chave), Query (Consulta) e Value (Valor). Elas são o coração do mecanismo de atenção nos Transformers, a arquitetura por trás de modelos como GPT-4 e Llama.
Muita gente acha que essa parte é só álgebra linear chata. Mas, na prática, é aqui que a mágica acontece. Se você entende como essas três peças conversam entre si, você entende como os LLMs processam significado. Vamos desmontar isso sem enrolação acadêmica, focando no que realmente importa: o que essas matrizes aprendem durante o treinamento e por que elas são tão poderosas.
A Analogia da Biblioteca: Entendendo Q, K e V
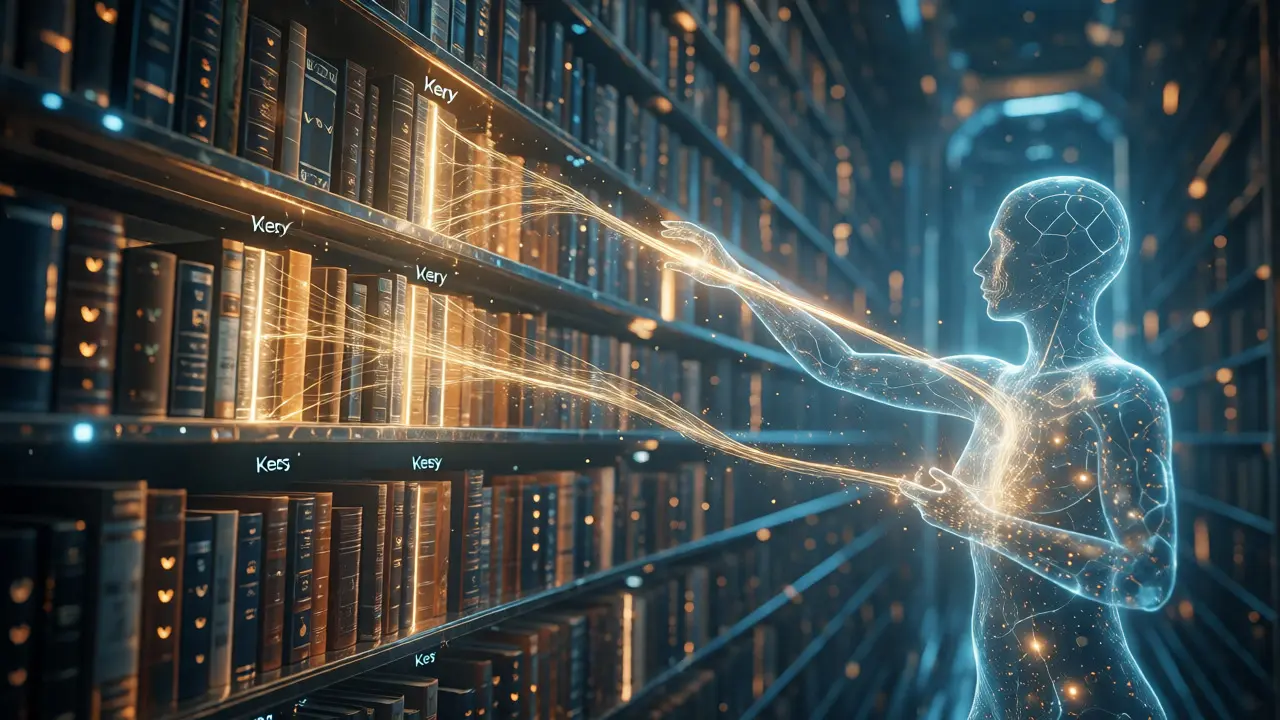
Para não se perder nas fórmulas, imagine que cada palavra (token) em uma frase é um livro em uma biblioteca gigante. O mecanismo de atenção funciona como um sistema de busca inteligente nessa biblioteca.
- Query (Q): É a pergunta que você faz. "Estou procurando informações sobre finanças." No modelo, o token atual gera uma Query perguntando: "Do que eu preciso saber para completar meu sentido agora?"
- Key (K): É a etiqueta ou índice do livro. Cada livro tem uma etiqueta dizendo sobre o que ele é. "Este livro fala sobre economia", "Este fala sobre madeira". As Keys ajudam o modelo a identificar quais tokens são relevantes para a Query.
- Value (V): É o conteúdo real do livro. Uma vez que você encontra os livros certos (comparando sua Query com as Keys), você lê o conteúdo deles (os Values) para construir sua resposta final.
O pulo do gato é que o modelo não usa etiquetas fixas definidas por humanos. Ele aprende, através de milhões de exemplos, quais "etiquetas" (Keys) tornam a busca mais eficiente para cada tipo de pergunta (Query).
O Que Realmente Acontece Matematicamente?
Na prática, quando um texto entra no Transformer, ele vira vetores numéricos chamados Embeddings representações densas de palavras em espaço vetorial. Esses vetores brutos não sabem quem são seus vizinhos na frase. Para descobrir isso, aplicamos três transformações lineares separadas usando matrizes de pesos treináveis ($W_q$, $W_k$ e $W_v$).
O processo segue estes passos:
- Projeção: Os embeddings originais são multiplicados por $W_q$, $W_k$ e $W_v$. Isso cria novos vetores específicos: Q, K e V. Note que Q, K e V vêm da mesma fonte original, mas são "projetados" para funções diferentes.
- Pontuação de Relevância: Calculamos o produto escalar entre o vetor Q de um token e todos os vetores K da sequência. Isso resulta em uma matriz de pontuações. Se o produto escalar for alto, significa que a Query e a Key estão alinhadas - ou seja, aquele token é relevante.
- Escala e Softmax: Dividimos essas pontuações pela raiz quadrada da dimensão do vetor (para evitar gradientes explosivos) e passamos por uma função softmax. Isso transforma as pontuações brutas em probabilidades que somam 1. Agora temos pesos de atenção claros.
- Combinação Ponderada: Multiplicamos esses pesos pelos vetores V correspondentes e somamos tudo. O resultado é um novo vetor para o token original, mas agora enriquecido com o contexto de toda a frase.
| Componente | Função Principal | Pergunta que Responde | Analogia na Busca |
|---|---|---|---|
| Query (Q) | Define o interesse do token atual | "O que estou procurando?" | A barra de pesquisa digitada pelo usuário |
| Key (K) | Identifica características dos outros tokens | "Como me identifico?" | As tags ou metadados dos resultados |
| Value (V) | Transporta a informação semântica útil | "Qual informação entrego?" | O conteúdo textual do artigo encontrado |
O Que Essas Matrizes Aprendem Durante o Treinamento?
Aqui é onde fica interessante. No início do treinamento, as matrizes $W_q$, $W_k$ e $W_v$ são aleatórias. O modelo está literalmente tateando no escuro. Conforme ele tenta prever a próxima palavra em bilhões de frases, ele ajusta esses pesos via retropropagação. O que ele descobre?
Ele aprende a separar aspectos sintáticos e semânticos. Por exemplo, em uma camada inicial, uma cabeça de atenção pode aprender que a Query de um verbo deve procurar Keys de substantivos próximos (relação sujeito-verbo). Em camadas mais profundas, outras cabeças podem aprender a conectar pronomes aos seus antecedentes distantes, ignorando palavras irrelevantes no meio.
Cada cabeça de atenção dentro de um bloco Transformer possui suas próprias versões dessas matrizes. Isso permite especialização. Enquanto uma cabeça foca em relações gramaticais locais, outra pode focar em co-referência (quem é "ele"?) ou até mesmo em tom emocional. Essa divisão de trabalho é o que dá aos Transformers uma capacidade superior de lidar com dependências de longo prazo comparado às RNNs.
Por Que Não Usar Apenas Um Vetor?
Você pode se perguntar: "Por que não usar o próprio embedding como Query, Key e Value?" A resposta curta é: falta de flexibilidade.
Se usássemos o mesmo vetor para tudo, estaríamos assumindo que a característica que torna uma palavra relevante para outra é exatamente a mesma característica que contém a informação útil. Isso raramente é verdade. Pense na frase: "O banco estava cheio". A palavra "banco" precisa olhar para "estava" e "cheio" para definir seu sentido. A Query de "banco" precisa buscar indicadores de estado ou quantidade. A Key de "cheio" precisa indicar que ela é um adjetivo descritivo. Se fossemos o mesmo vetor, misturaríamos a identidade da palavra com sua função contextual, tornando a busca menos precisa.
As projeções permitem que o modelo decouple (separe) "quem sou eu" (identidade/key) de "do que preciso" (consulta/query) e "o que tenho a dizer" (valor/value). Essa separação de preocupações é crucial para a eficiência do aprendizado.
Impacto Prático no Desempenho dos LLMs
Entender QKV ajuda a diagnosticar problemas reais. Quando um modelo alucina ou perde o fio da meada em textos longos, muitas vezes o problema está na dispersão das atenções. Se os pesos de atenção ficam muito espalhados (todos os tokens recebem peso quase igual), o modelo não consegue focar na informação chave. Isso pode acontecer se as matrizes $W_k$ e $W_q$ não estiverem bem treinadas para criar contrastes fortes entre tokens relevantes e irrelevantes.
Além disso, técnicas modernas como Grouped-Query Attention (GQA) surgiram justamente para otimizar esse processo. Em modelos gigantes, manter Keys e Values únicos para cada cabeça consome muita memória. GQA compartilha algumas Keys e Values entre várias Queries, reduzindo o custo computacional sem sacrificar drasticamente a qualidade. Saber que Q, K e V têm custos diferentes ajuda engenheiros de IA a equilibrar velocidade e precisão.
Dicas para Quem Trabalha com LLMs
Se você trabalha com fine-tuning ou desenvolvimento de aplicações baseadas em LLMs, considere estas heurísticas:
- Visualize as Atenções: Ferramentas como BertViz mostram mapas de calor de atenção. Verifique se as cabeças estão focando em partes lógicas do texto. Se a atenção está "vazando" para tokens de pontuação irrelevante, pode haver ruído nos dados de treino.
- Camadas Importam: Camadas baixas tendem a ter padrões de atenção mais locais e sintáticos. Camadas altas são mais abstratas e semânticas. Ao fazer prompt engineering, posicione instruções críticas onde a atenção global é mais ativa.
- Janela de Contexto: A complexidade da atenção escala quadraticamente com o tamanho da sequência. Embora existam otimizações, entender que cada token consulta todos os anteriores explica por que contextos longos ficam caros e lentos.
O que são as matrizes Wq, Wk e Wv?
São matrizes de pesos aprendíveis que projetam os embeddings de entrada nos espaços de Consulta (Query), Chave (Key) e Valor (Value). Elas transformam a representação bruta da palavra em representações especializadas para o cálculo de atenção.
Por que dividimos o produto escalar pela raiz de d?
A escala previne que os valores do produto escalar cresçam demais à medida que a dimensão dos vetores aumenta. Valores grandes levam a gradientes pequenos na função softmax, dificultando o treinamento. A divisão estabiliza a distribuição de probabilidade.
As matrizes Q, K e V são fixas após o treinamento?
Os pesos das matrizes de projeção ($W_q$, $W_k$, $W_v$) são fixos após o treinamento completo. No entanto, os vetores Q, K e V resultantes mudam dinamicamente a cada nova entrada, pois dependem dos embeddings específicos do texto atual.
Qual a diferença entre Self-Attention e Cross-Attention?
No Self-Attention, Q, K e V vêm da mesma sequência de entrada. No Cross-Attention (usado em tarefas como tradução), Q vem de uma sequência (ex: saída do decoder) enquanto K e V vêm de outra (ex: entrada do encoder). A lógica de cálculo permanece a mesma.
Como as múltiplas cabeças de atenção usam QKV?
Cada cabeça de atenção possui suas próprias instâncias independentes das matrizes de projeção. Isso permite que diferentes cabeças aprendam diferentes tipos de relacionamentos (sintáticos, semânticos, posicionais) simultaneamente, capturando nuances que uma única matriz não conseguiria.